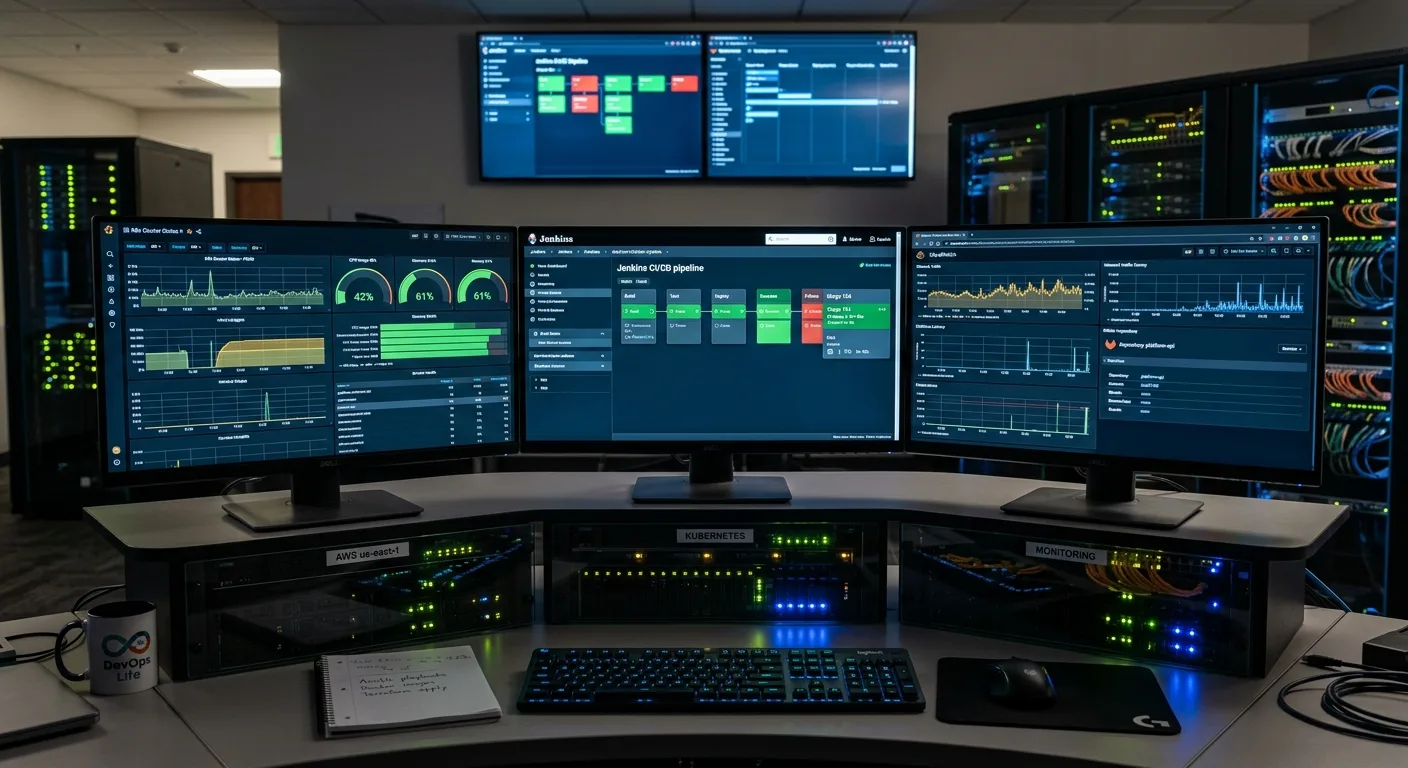
Značaj i uloga monitoringa i logovanja u DevOps-u
Monitoring i logovanje predstavljaju okosnicu stabilnosti i performansi u DevOps ekosistemu, omogućavajući timovima da steknu dubok uvid u ponašanje aplikacija i infrastrukture. Kontinuirano praćenje omogućava rano otkrivanje anomalija i potencijalnih problema, pre nego što eskaliraju u kritične incidente.
Efikasno logovanje, s druge strane, pruža detaljne tragove o sistemskim događajima, greškama i korisničkim interakcijama, što je ključno za brzu dijagnostiku i rešavanje problema. Zajedno, ove prakse doprinose proaktivnom održavanju i optimizaciji sistema, smanjujući zastoje i poboljšavajući korisničko iskustvo.
Ključni indikatori performansi (KPIs) za praćenje infrastrukture i aplikacija
Identifikacija relevantnih KPI-jeva je presudna za efikasan monitoring; oni obuhvataju metrike poput iskorišćenosti CPU-a, memorije, diska i mrežnog saobraćaja, kao i specifične performanse aplikacija poput vremena odziva, broja grešaka i propusnosti transakcija. Ovi indikatori omogućavaju objektivnu procenu zdravlja sistema.
Pored tehničkih metrika, važno je pratiti i poslovne KPI-jeve koji direktno odražavaju uticaj tehničkih performansi na krajnje korisnike i poslovne ciljeve. Redovno analiziranje ovih podataka pomaže u donošenju informisanih odluka o optimizaciji i poboljšanju sistema.
Pravi monitoring nije samo prikupljanje podataka, već razumevanje šta ti podaci znače za stabilnost i budućnost vašeg sistema.
Alati i najbolje prakse za centralizovano logovanje i analizu
Implementacija centralizovanog sistema za logovanje je fundamentalna za efikasno upravljanje podacima iz različitih izvora, omogućavajući timovima da pretražuju, filtriraju i analiziraju logove na jednom mestu. Alati poput ELK steka (Elasticsearch, Logstash, Kibana) ili Splunk-a nude moćne mogućnosti za agregaciju i vizualizaciju logova.
Najbolje prakse uključuju standardizaciju formata logova, implementaciju granularnog logovanja bez prevelikog opterećenja sistema i redovno arhiviranje starih logova. Automatska analiza logova može otkriti obrasce i anomalije koje bi ručnom inspekcijom bilo teško uočiti.
Postavljanje efikasnih sistema za uzbunjivanje i automatizovane reakcije na incidente
Efikasni sistemi za uzbunjivanje su ključni za brzu reakciju na probleme, obaveštavajući relevantne timove čim se detektuje kritična situacija, na osnovu predefinisanih pragova i KPI-jeva. Konfigurisanje uzbunjivanja treba da bude precizno kako bi se izbegao zamor od lažnih alarma.
Automatizovane reakcije na incidente, kao što su automatsko skaliranje resursa, ponovno pokretanje servisa ili izvršavanje korektivnih skripti, mogu značajno smanjiti vreme potrebno za oporavak. Integracija ovih sistema sa alatima za obaveštavanje obezbeđuje kontinuitet poslovanja i minimalizuje ljudsku intervenciju.